이런 분께 적합합니다
- 영문 AI 논문과 연구 블로그를 읽는 이공계 학부 고학년·대학원생
- 랩 미팅이나 저널 클럽에서 논문을 요약해야 하는 분
- AI 기술을 업무에 활용하며 영어 문서도 읽는 개발자·기획자
- 단어 뜻은 알지만 연구 내용에 맞게 이해하거나 영어로 질문하는 데 어려움을 느끼는 분
실험 설명의 bias와 공정성 문서의 bias는 같은가요?
발표 자료를 준비하며 “We remove the bias term from the output layer.”를 읽었다고 해봅시다. ‘모델에서 편향을 없앴다’고 요약하면 될까요? “We evaluate sampling bias in the training data.”와 나란히 놓으면, 같은 bias라도 무엇을 말하는지부터 구분해야 한다는 점이 보입니다.
첫 문장의 출력층은 모델이 최종 출력을 만드는 부분이며, bias term은 그 계산에 더해지는 값입니다. 두 번째 문장은 훈련 데이터가 어떤 방식으로 뽑혔는지를 검토합니다. 따라서 “bias를 제거했으니 더 공정해졌다”는 요약은 두 문장 어디에서도 바로 나오지 않습니다. 같은 번역어라도 무엇을 가리키는지에 따라 확인할 근거가 달라집니다.
논문을 읽다가 멈췄을 때 원인을 나눠보세요. 단어의 뜻이 낯선지, 문장 구조가 복잡한지, 아니면 그 문장이 전제하는 모델을 모르는지. 마지막 경우에는 번역을 여러 번 바꾸기보다 수식이나 방법 절로 돌아가는 편이 낫습니다. 영어 문제처럼 보이지만 개념의 빈칸일 수도 있습니다.
attention: ‘집중한다’는 비유에서 멈추지 않기
일상 영어의 attention은 ‘주의’나 ‘관심’이지만, AI 논문에서는 보통 ‘어떤 입력 정보를 얼마나 반영할지 계산하는 메커니즘’을 말합니다. 여러 정보에 서로 다른 가중치, 즉 반영 비중을 주어 조합한다고 생각하면 출발점을 잡기 쉽습니다. Attention Is All You Need도 집중력에 관한 조언이 아니라 Transformer 구조를 제안한 논문입니다.
예를 들어 문장 속 대명사를 이해하려면 앞에 나온 어떤 대상을 가리키는지 살펴야 합니다. attention은 이런 관련 정보를 반영하는 계산에 쓰일 수 있지만, 사람이 의식적으로 집중하는 것과 같지는 않습니다. self-attention은 하나의 입력 시퀀스, 즉 순서가 있는 정보 묶음 안에서 정보를 서로 참조합니다. cross-attention은 다른 시퀀스의 정보를 참조하는 방식입니다. 정확한 연결은 해당 모델의 그림과 정의에서 확인하세요.
예를 들어 “The model attends to earlier tokens.”를 읽었다면 “앞부분을 잘 이해한다”로 바로 바꾸지 마세요. 모델이 앞선 토큰의 정보를 참조하는 방식과, 그 결과 추론을 정확히 했다는 주장은 다릅니다. 성능에 관한 결론은 평가 결과를 별도로 봐야 합니다. 표현의 의미를 정리할 때도 메커니즘의 설명과 연구자가 관찰한 결과를 분리해 적습니다.
bias: 한 분야 안에서도 뜻이 다시 갈립니다
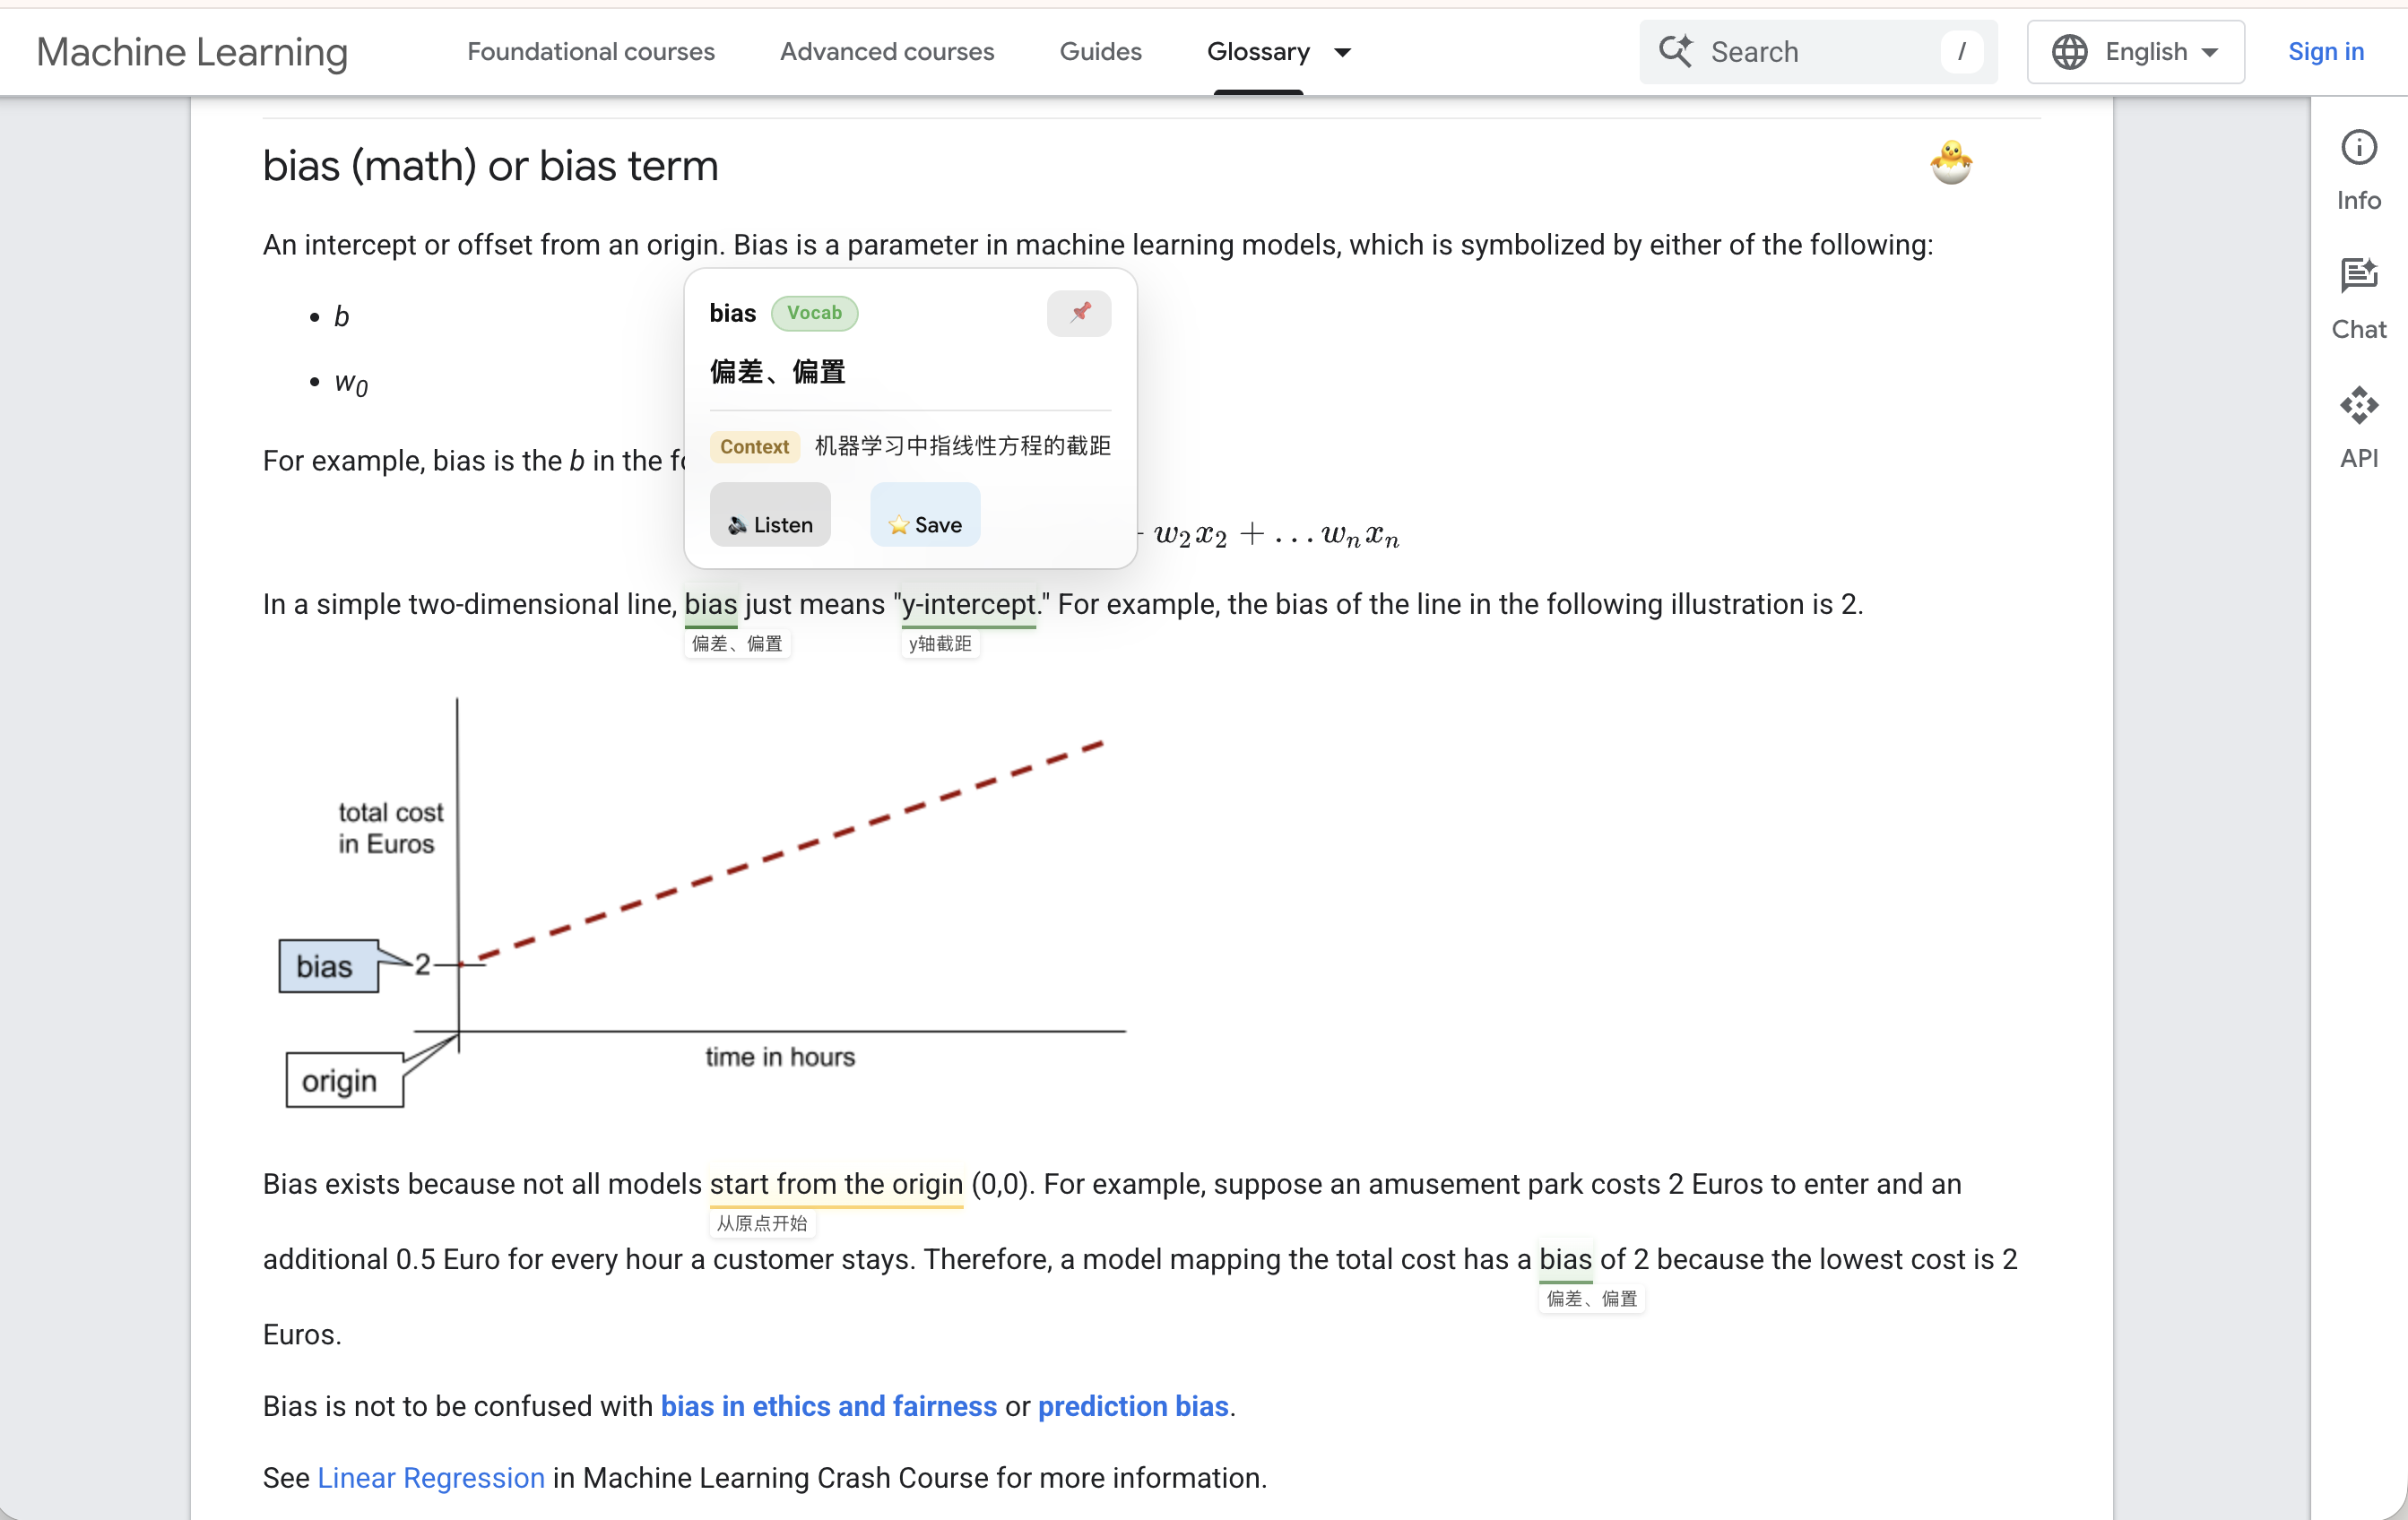
Google의 머신러닝 용어집은 수학적 bias term과 윤리·공정성 관련 bias를 구분합니다. 이를 단순히 “AI에서는 편향이라는 뜻”으로 외우면, 중요한 구분을 놓칩니다. 수식의 b, 훈련 표본을 설명하는 단락, 집단별 결과를 비교하는 표는 각각 다른 단서를 줍니다.
수식 y = wx + b에서 b를 떠올려보세요. x에 w를 곱한 값에 더해지는 별도의 값으로, 직선의 위치를 위아래로 옮길 수 있습니다. 이 b 같은 항이 bias term입니다. ‘편향 항’이라는 번역만으로 어렵다면, 이 단순한 식에서는 예측값에 더하는 기본 조정값이라고 이해해보세요. 사람에 대한 편견을 뜻하는 것은 아닙니다.
반면 sampling bias는 데이터를 모은 방식 때문에 일부 대상이 과도하거나 부족하게 대표되는 문제입니다. 가령 맑은 날 사진만 잔뜩 모았다면, 비 오는 날까지 대표하는 자료라고 보기 어렵습니다. Google 용어집의 prediction bias는 예측값의 평균과 실제 정답값의 평균이 얼마나 어긋나는지를 말합니다. 모델의 조정값, 표본의 대표성, 예측 평균의 차이는 같은 문제가 아니므로, 확인 방법도 달라집니다.
노트에 “bias = 편향”만 남기는 대신 “bias term — 모델 식의 항”처럼 대상까지 남겨보세요. 다음 논문에서 같은 단어를 만났을 때 이전 뜻을 그대로 붙이지 않고, 그 논문의 정의와 대조할 수 있습니다. 특히 한 논문 안에서 용법이 바뀔 수도 있으므로 초록에서 잡은 뜻을 끝까지 고정하지 마세요.
| 표현 | 쉽게 풀어보면 | 확인할 것 |
|---|---|---|
| bias term | 모델 식에서 더해지는 조정값 | 수식에서 어떤 역할을 하는가 |
| sampling bias | 모은 자료가 일부 대상을 치우쳐 대표하는 문제 | 누구의 자료가 많이 또는 적게 포함됐는가 |
| prediction bias | 예측 평균과 실제 정답 평균의 차이 | 어떤 데이터에서 어떻게 계산했는가 |
token: 영어 단어 수와 모델의 입력 단위는 다릅니다
이 문맥의 token은 모델이 텍스트를 나누어 처리하는 단위입니다. 토크나이저는 그 나누는 규칙을 적용하는 도구라고 생각하면 됩니다. 단어 하나가 한 토큰이 되기도 하지만, 단어의 일부나 문장부호가 처리 단위가 되기도 합니다. Hugging Face의 설명도 단어보다 작은 조각으로 나누는 방식을 다룹니다.
이해를 위한 예로 playing을 play와 ing처럼 나누어 생각해볼 수 있습니다. 다만 실제 토크나이저가 반드시 이렇게 자른다는 뜻은 아닙니다. 어떤 조각을 쓰는지는 모델이 사용하는 규칙과 어휘 목록에 따라 달라집니다. 그래서 token은 ‘어려운 뜻으로 바뀐 일상 단어’로만 외우기보다, 이 분야에서 쓰는 처리 단위의 개념으로 이해해야 합니다.
따라서 “The input is limited to 512 tokens.”를 “영어 512단어까지”로 기억하면 입력 길이를 잘못 설명할 수 있습니다. 여기의 512는 학습용 예문의 숫자일 뿐 특정 제품의 한도가 아닙니다. 실제 문서에서는 어떤 모델의 어떤 제한인지, 특수 토큰과 출력 길이를 어떻게 취급하는지 확인합니다.
한국어 문장과 영어 문장은 글자 수가 비슷해도 토큰 수가 같다고 가정할 수 없습니다. 숫자를 고정된 환산표로 외우기보다 해당 모델의 토크나이저로 직접 확인하세요. 논문 요약에는 “단어 수”를 임의로 보태지 않고 원문의 단위와 설정을 유지합니다.
랩 미팅 준비, 논문에서 어디부터 읽으면 좋을까요?
전체 논문을 첫 줄부터 번역하기 전에 오늘 답할 질문을 정합니다. 예를 들어 “이 방법은 같은 평가 조건에서 기존 방법보다 나은가?”입니다. 초록에서 결론을 찾고, 방법과 실험 절에서 그 결론을 읽는 데 필요한 정의와 비교 대상을 확인합니다. 관련 연구를 전부 이해하기 전에도 한 주장에 필요한 근거부터 추적할 수 있습니다.
본문의 의미를 바꾸는 말은 종종 쉬운 단어입니다. only, may, under, compared with와 부정을 놓치지 마세요. 학습 예문“The method improves accuracy on the small dataset, but not on the larger benchmark.”를 “정확도가 개선됐다”로만 요약하면 적용 범위가 사라집니다. 표의 데이터셋과 실험 설정까지 연결해야 합니다.
수업 발표라면 핵심 아이디어와 결과, 한계부터 정리해보세요. 내 연구에 적용할 방법을 찾는 중이라면 데이터와 실험 설정을 더 살펴야 하고, 직접 재현하려면 코드·전처리·하이퍼파라미터까지 필요합니다. 지금 설명해야 할 내용이 무엇인지 정하면, 긴 논문에서도 시간을 더 들여 읽을 부분을 고르기 쉽습니다.
- 질문을 하나 정하기예: “어떤 조건에서 기존 방법보다 나아졌는가?”
- 용어의 대상을 적기bias가 식의 항인지 표본 문제인지 구별합니다.
- 근거 위치 찾기정의, 수식, 표, 실험 설정의 위치를 남깁니다.
- 조건을 보존해 요약하기데이터셋과 비교 기준을 지우지 않고 두 문장으로 적습니다.
단어장 대신, 다시 쓸 수 있는 표현을 남기는 법
분야 용어만 모으면 논문을 말로 설명할 때 다시 막힐 수 있습니다. 실제 발표에서는 “무엇을 가정했는지”, “어떤 것과 비교했는지”, “어디까지 적용되는지”를 이어야 하기 때문입니다. attention과 함께 attend to, bias와 함께 evaluate bias in, 결과와 함께 compared with the baseline처럼 역할이 있는 묶음을 남겨보세요.
표현을 저장한 뒤에는 짧은 개인 메모를 덧붙여보세요. 어디서 읽었는지, 그 문맥에서 무엇을 설명했는지, 내 연구에서는 어떤 문장으로 쓸 수 있을지를 적습니다. 예를 들어 under the same training conditions를 남겼다면, 다음 랩 미팅에서 두 모델의 비교 조건을 물을 때 써볼 수 있습니다.
| 남길 항목 | 학습용 예시 |
|---|---|
| 표현 | under the same training conditions |
| 이 문맥의 역할 | 비교 조건이 같다는 전제를 밝힘 |
| 내가 확인할 것 | 데이터, 학습량, 평가 방식의 실제 조건 |
| 내 설명으로 바꾸기 | We need to compare the models under the same training conditions. |
LeMingle로 읽는 흐름을 지키고, 발표에 쓸 표현을 모으기
학습 시간을 따로 확보하기 어렵다면, 어차피 읽어야 하는 연구 자료에서 영어 표현도 함께 익히는 편이 현실적입니다. LeMingle은 데스크톱 Chrome / Edge용 확장 프로그램입니다. 전문 분야를 사용자 지정으로 선택하고 Machine learning을 입력한 뒤, 공개 연구 블로그나 HTML 논문에서 시작해보세요.
표시된 표현에 마우스를 올리면 뜻풀이와 발음을 확인할 수 있습니다. 원문이 그대로 보이므로 bias가 어떤 대상을 가리키는지 앞뒤 문장과 함께 살피기 좋습니다. 뜻을 확인하려고 매번 페이지를 벗어나는 대신, 읽던 문장에서 이해를 이어갈 수 있다는 점이 이 방식의 장점입니다.
다음 발표에 쓸 만한 표현은 저장하고 플래시카드로 복습하세요. 지원되는 웹페이지에서 저장한 표현을 다시 만나면 하이라이트가 회상을 도와줍니다. 여기서 한 번 더 해볼 일은 뜻풀이를 가리고 자기 연구에 관한 문장으로 말하는 것입니다. 읽고 끝내는 습관을 바꾸고 싶은 대학원생과 개발자에게 LeMingle을 추천하는 이유도 이 연결에 있습니다.
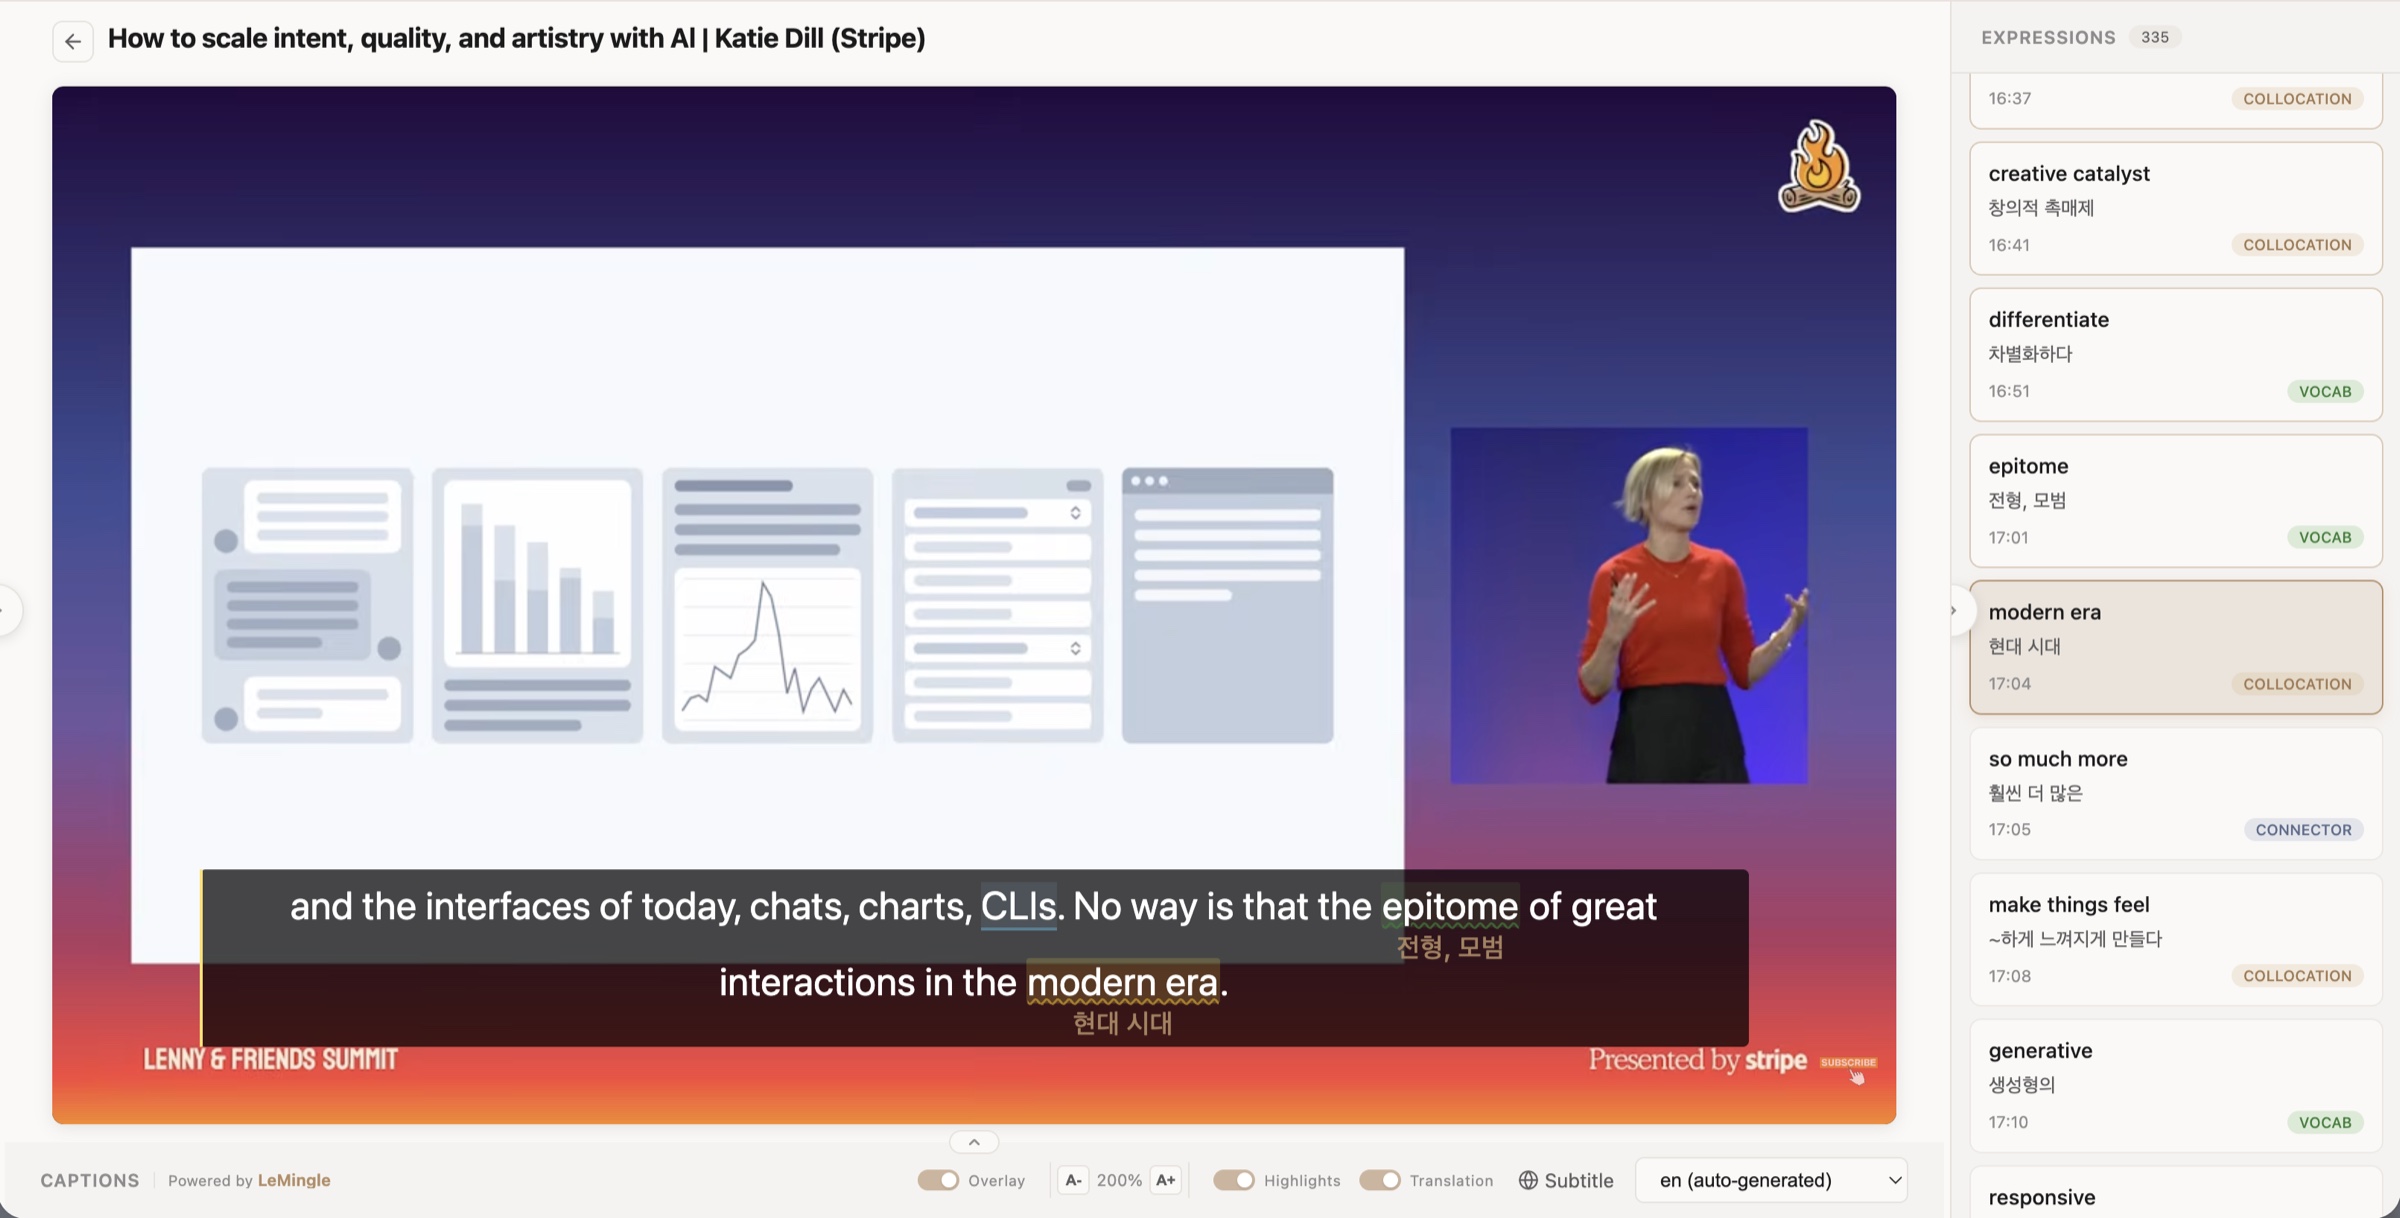
말하는 속도와 강세까지 익히려면 한국어 YouTube Reader로 기술 발표의 원음과 자막을 확인해보세요. 더 많은 문서 예시는 기술 문서 영어 가이드에서 이어집니다. PDF 뷰어와 스캔 문서의 지원은 일반 웹페이지와 다를 수 있으며, 논문의 수식과 주장은 원문으로 검토해야 합니다. 비공개 자료에는 소속 기관의 외부 AI 이용 규정을 먼저 확인하세요.
랩 미팅에서 두 문장으로 설명하기
이제 원문을 닫습니다. “재미있는 논문이었다” 대신 방법이 무엇인지, 어떤 관찰을 했는지, 무엇은 아직 말할 수 없는지 설명해보세요. 학습 예시“The paper compares two tokenizers on a multilingual dataset. It does not show that either tokenizer is best for every language.”는 비교의 범위를 남기면서 일반화를 막습니다.
이 문장 틀에 지금 읽는 논문의 비교 대상과 결과를 넣어보세요. 저자의 결과를 소개할 때는 “The authors report…”, 우리 연구에 적용할 가능성을 이야기할 때는 “We still need to check…”로 이어갈 수 있습니다. 이렇게 표현을 묶어두면, 발표 중 결과와 후속 질문을 연결할 때 도움이 됩니다.
먼저 한국어로 핵심과 조건을 정리한 뒤, 영어로 짧게 말해보세요. “무엇을 비교했나요?”라는 질문에도 답할 수 있으면 좋습니다. 도중에 막힌 표현은 다시 소리 내어 연습하고, 다음 랩 미팅에서 쓸 질문 하나까지 준비해보세요. 읽은 내용을 실제 대화로 옮길 기회가 생깁니다.
확인 문제: 뜻을 아는 것과 결론을 읽는 것은 다릅니다
문제 1. “The model uses a bias term, and the training sample may contain selection bias.” bias가 두 번 나옵니다. 둘 다 같은 수식의 항일까요? 아닙니다. 앞은 모델 구성 요소, 뒤는 표본 선택의 문제입니다. may도 지우지 마세요. 해당 문제가 확정됐다는 말은 아닙니다.
문제 2. “The score increased after we changed the tokenizer.” 이것만으로 바뀐 토크나이저가 모든 환경에서 더 낫다고 결론 낼 수 있을까요? 없습니다. 데이터, 설정, 평가 기준과 다른 변화가 있었는지 확인해야 합니다. 문법적으로 자연스러운 인과 설명을 추가해도 그 근거가 새로 생기지는 않습니다.
마지막으로 오늘 읽은 자료에서 다시 쓰고 싶은 표현 하나를 골라보세요. 그 문맥의 뜻을 확인한 다음, 내 연구를 설명하는 문장으로 바꾸어 말해봅니다. 다음 발표에 쓸 수 있을 것 같다면 저장해두세요. 논문 한 편을 읽을 때마다 이렇게 남긴 표현이 있으면, 다음에는 처음부터 영어 문장을 만들지 않아도 됩니다.
자주 묻는 질문
논문 영어가 어려우면 단어부터 더 외워야 하나요?
어휘 부족인지 개념의 빈칸인지 먼저 구분하세요. 단어는 알지만 문장이 이상하다면 해당 분야의 정의와 주변 수식, 비교 조건을 확인합니다. 개념 자체가 낯설다면 입문 자료가 필요하며 번역만 바꾸는 것으로 해결되지 않을 수 있습니다.
bias는 항상 편견을 뜻하나요?
아닙니다. 모델의 편향 항, 표본 추출의 문제, 공정성 논의 등 가리키는 대상이 다릅니다. 목적어와 수식, 데이터 설명을 보고 그 글이 정의한 뜻을 확인합니다.
토큰 수를 영어 단어 수나 한국어 글자 수로 바꿔도 되나요?
고정된 비율로 바꾸지 마세요. 토크나이저와 어휘에 따라 단어가 여러 단위로 나뉠 수 있습니다. 실제 한도나 실험을 다룰 때는 사용한 모델과 토크나이저를 확인합니다.
LeMingle은 논문 영어를 공부할 때 어떻게 쓰면 좋나요?
전문 분야를 Machine learning 등으로 지정하고, 공개 연구 블로그나 HTML 논문의 표현을 문맥 속에서 확인해보세요. 필요한 표현은 저장해 복습하고, 자기 연구에 맞는 문장으로 말해보면 좋습니다. PDF 뷰어와 스캔 문서의 지원은 다를 수 있으며, 수식 검증이나 논문 평가를 대신하는 도구는 아닙니다.
참고 자료
자료 확인:2026-10-29
LeMingle 편집팀이 작성한 글로, 제품 소개에는 상업적 이해관계가 있습니다. 공식 자료의 설명과 별도로 만든 학습 예문을 구분해 제시했습니다. 뜻풀이에는 오류가 있을 수 있으므로 중요한 용어와 연구 주장은 원문으로 확인하세요.
- Vaswani 외 — Attention Is All You Need논문 제목과 Transformer의 연구 맥락을 확인. 본문의 실험·발표 문장은 별도 학습 예시입니다.
- Google — Machine Learning Glossaryattention과 bias의 서로 다른 전문적 의미를 확인했습니다.
- Hugging Face — Tokenization algorithms토큰과 단어의 차이, 서브워드 방식의 개념을 확인했습니다. 본문의 분할 예시는 이해를 위한 설명이며 특정 모델의 실제 출력은 아닙니다.